

我參加一個單位的月會。會前十分鐘,護理長在筆電上開啟系統匯出的稽核清單,切到單位同仁填寫複核回覆的電子表格。
前幾筆有回覆:已核對原始紀錄、需要補充說明、確認為缺失。
再往下捲,回覆欄一片空白。
她把畫面轉過來,指著那些空格說:
「這個我們都有看喔。」
然後她點開第三筆,說這一筆有做,紀錄登在另一個系統模組。第五筆也是。第六筆那位病人當時在轉床。第七筆是真的,那個確實漏了。
她說:「我們一開始每一筆都查。查到後來,同仁問我,那可不可以只看紅色的。」
我把這些例子記下來。接下來需要品管團隊核對判準、資訊同仁確認資料擷取範圍,再和單位一起討論複核量,才知道該改哪一段。
散會後,我一直在想那句「這個我們都有看喔」。打開清單和完成複核之間,隔著同仁切換系統、查核紀錄、詢問當事人、填寫回覆的時間。那些空格,不能直接解讀成單位沒有看。
但那是一個系統開始被關掉的樣子——而且是最禮貌的那一種。
沒有人正式宣布停用,清單也照常產生,排程照跑,檔案照生。只是同仁已經無法逐筆接著處理,電子表格後面的回覆欄越留越多。
這個死法你們見過。一個東西下線,通常不是靠一次決策,是靠沒有人再去點它——服務還活著,儀表板還在,排程沒有停,只是那個 queue 的積壓曲線再也沒有人看第二眼。東西沒有壞掉,它只是不再有人接在後面。
Day 9 那篇結尾我留了三樣東西沒處理完。
一個是指標:複核成立率——每一百筆被標記的問題裡,經人複核確認成立的有幾筆。我當時寫它比準確率重要,卻不知道該把它拉到多少才算及格,也不知道拉不上去該怎麼辦。
一個是一句話。小葉——品管室裡實際下去跑複核的那位同仁——複核完手上那批,把筆電闔起來說:「這樣下去,沒有人會想看第二次。」我當時把它聽成抱怨。
還有一件:我們當時決定不調閾值,後來到底調了沒有。今天一起回答。
先講一件品管領域很老、老到不太有人講的事。
稽核的產出不是報告,是接收端的行為改變。 一份沒有人採取行動的稽核報告跟沒做等價——消耗人力、產生檔案、在委員會上被念過一次,然後什麼都沒發生。所以稽核系統真正的效能指標從來不是「找到多少問題」,是「有多少問題被處理了」。
而醫療資訊這一行早就摔過一次很有名的跤。醫囑系統有藥物交互作用警示——開藥時如果兩種藥不該一起用就跳出提示。上線後覆蓋率愈做愈高,然後大家發現:醫師點掉提示的比例也一路往上。二十幾年下來,這個領域累積出一個殘酷的共識:
警示的效益不會隨數量單調上升。過了某一點,多一條警示會讓整組警示的效益下降。
不是趨近於零,是往下掉——多出來的那些會稀釋掉真正該被看見的幾條,讓人對整個提示區塊養成「先點掉再說」的肌肉記憶。
你們有一模一樣的東西,叫 alert fatigue:那個沒人看的 #alerts 頻道、那條被設靜音的通知規則、那個在 CI 裡跑了三年、每次都黃、每次都被直接 merge 的 warning。我只是把醫院這一課,在一個新系統上又上了一次。
Day 16 跟 Day 19 提過那個透析中低血壓的預警系統。當時我把它想成一個模型問題,很久以後才看清楚它的分類:它從頭到尾就是一個 alert,只是被告警的對象是一位躺在那裡洗腎的病人。
而一個 alert 要落到哪裡去?落到透析室。那個房間本來就一直在響——透析機的壓力告警、空氣偵測、旁邊那幾床各自的機器,一班下來響很多次,其中絕大多數不需要任何人做任何事。護理師在那樣的環境裡練出來的第一個本能,不是「去看那是什麼」,是先把聲音按掉。
alert fatigue 這個詞不是從工程圈長出來的,是從這種房間裡長出來的。我當年在意的是模型能不能提前十幾分鐘報出來;我沒有問的是,這一聲報出來之後,它要跟現場那一整片聲音擠在同一個耳朵裡。
一個新的告警不是加進一片安靜,是加進一片已經很吵的聲音。
準不準,跟會不會被聽見,是兩個獨立的問題。我花了很久才承認第二個問題不歸模型管——它歸我管。
先把核心命題講清楚:
一個準確但太吵的系統,實務壽命比一個略遜但安靜的系統短。
這違反直覺,因為我們評估系統時看的是準確率,而準確率高的那個怎麼看都比較好。問題是,使用者評估的不是同一個東西。
護理長不知道這套系統的準確率是多少,也不需要知道。她心裡跑的是一個很單純的算式:
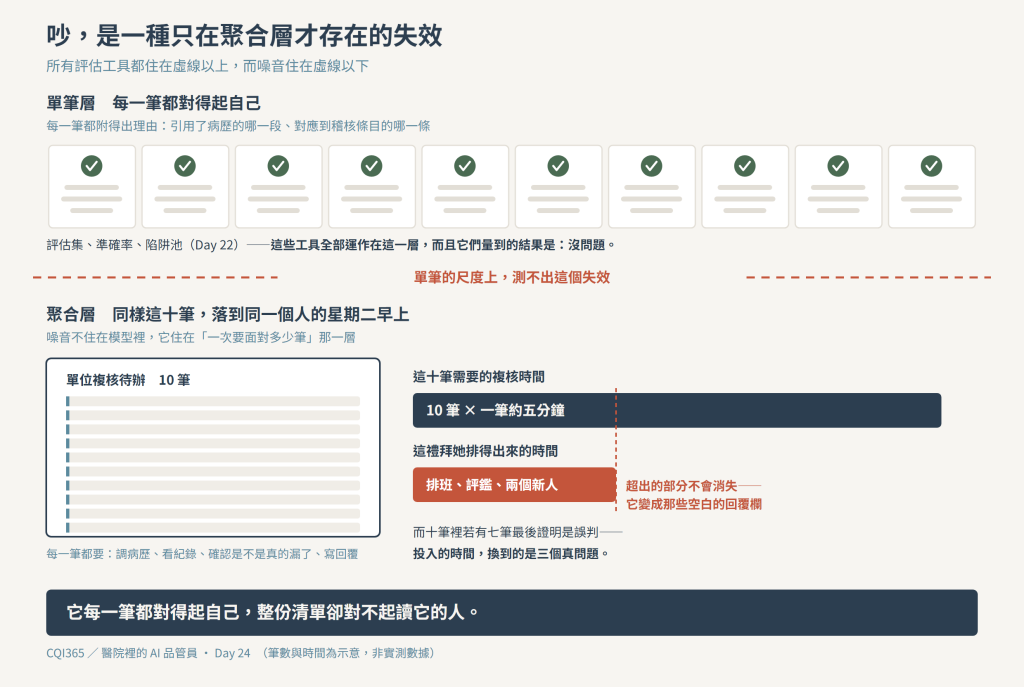
查一筆要多久?大概五分鐘——調病歷、看紀錄、確認是不是真的漏了、寫回覆。如果十筆裡有七筆最後證明是誤判,單位合計要投入五十分鐘,才換到三個真問題。而她的單位這禮拜還有排班要排、評鑑資料要準備、兩個新人要帶。
這個算式你們每天也在跑,只是不會講出來:一個 flaky test 連續三次紅掉又三次重跑就過,第四次紅的時候你點進去看的機率是多少?你不是不在乎正確性,你是算過了——點進去的期望值太低。護理長跑的是同一個算式,只是她的單位換算成的是人力。
這個算式一旦跌破某條線,理性的做法就是不看。使用者棄用不是不理性,恰恰是因為他太理性。 他在做的是資源配置決策,而他的資源比你以為的緊得多。
所以 Day 9 那個指標的意義到今天才完整:複核成立率不是技術指標,它是使用者那個算式的分子。 它衡量的不是模型多聰明,是打開這份清單的人願不願意打開第二次。
至於該拉到多少算及格——這個問題本身問錯了。及格線不在系統這一端,在接收端。 同樣的成立率,有專責品管窗口的大單位可以接受,護理長要兼三件事的單位就不行。你得去問,不能自己訂。
這跟你訂 SLO 的方式其實一樣:99.9% 不是從機器裡量出來的,是跟依賴你的那一方談出來的——你只量得到自己的可用性,量不到對方賠不賠得起那 0.1%。沒有接收端,就沒有及格線。
品管人的直覺一向是寧可錯殺:漏掉一個真的病人安全問題,代價不是報表難看,是病人。所以第一版設計討論偏向把判準訂得很緊,寧可多標一些讓單位複核。我當時也支持這個取向。
這在抽樣時代是對的——一個月看二十份,多標三筆假的,接收端吸收得掉。全量之後同一個直覺變成致命的:母體放大了兩三個量級,誤判的絕對筆數跟著放大,接收端人力卻一個都沒增加。Day 9 講過稀缺資源已從閱讀量移到複核量,我看懂了那件事,卻沒看懂下一步——稀缺的東西換了位置,原本正確的偏好也要跟著換邊。
這件事在工程上有個對應:一條 assertion 寫在跑一百筆的批次裡很合理,出問題就該炸;同一條放進一天跑一千萬次的 pipeline,它就從保護機制變成噪音來源。條件沒變、寫法沒變,變的是它一天要對多少人講幾次話。
同一個專業直覺,換一個量級之後,就從對的變成錯的。
這是 Day 9 那個懸念的答案:我們後來確實沒有回去調閾值。不調是因為想清楚了一件事——閾值跟容量是兩件事,我第一版把它們接在同一個旋鈕上,那是設計錯誤。
而那個容量不是我算得出來的。它等於這個單位這個月有幾位同仁、其中幾位要帶新人、評鑑前那兩週又要扣掉多少,還有那位剛好休長假的。這些數字在護理長的排班表上,不在我的資料庫裡。
所以我們改的不是閾值,是輸出的形狀:從「輸出所有超過閾值的」,改成「排序後輸出前 N 筆,N 由該單位這個月能吸收的量決定」。剩下的不是丟掉,是留在池子裡等下一輪。
用你們的語言講,這是把 alerting 從 threshold-based 改成 budget-based:你的 on-call 一週能吃下幾個 page,是設計的先決條件,不是跑出來的結果。
先問接收端一週能處理幾筆——這是設計輸入,不是驗收數字。
那句「可不可以只看紅色的」,其實是護理長自己在幫我做分級。她發現清單裡的東西不等重,於是發明了一套規則:紅的看,其他跳過。那套規則是她編的,我控制不了。
使用者會自己發明分級,如果你不給他們。而他們發明的版本,你控制不了。
所以分級要由系統給,而且關鍵不在分幾級,在於不同級走不同的通道:
| 等級 | 意思 | 去哪裡 |
|---|---|---|
| 請處理 | 把握高,且影響病人安全 | 進單位待辦,有回覆期限 |
| 請確認 | 需要現場資訊才能確定 | 進月報,一次批量看 |
| 僅供參考 | 值得注意,但不要求動作 | 只進統計,不進任何人的收件匣 |
最後一行是重點。錯誤做法是全部塞進同一張清單、加一個顏色欄位——顏色不會減少閱讀量,人還是得一行一行掃才知道哪些是紅的。真正減少負擔的是根本不出現在他面前。
你們的 severity 分級早就在做同一件事,而且做得比我們狠:severity 決定的不是顏色,是通道——P1 打斷 on-call 的睡眠,P3 進 backlog 等排程,剩下的只寫進 log、不通知任何人。如果三種都丟進同一個頻道再加三種 emoji,那不叫分級,那叫把分類這件工作外包給讀的人。
每一筆標記旁邊要有一個「這不是問題」的按鈕,按下去要追問一句為什麼。那一句不必長——一個下拉選單加一格自由填答就夠,要讓護理同仁在交班前那三分鐘填得完,否則沒有人會填。理由有兩個,第二個重要得多。
第一,那是唯一能拿到真實偽陽性標註的管道。Day 22 的陷阱池給的是我定義的缺陷,終究是我出的題;現場回饋給的是他們定義的——「這個我們登在另一張表上」,我在辦公室裡永遠設計不出來。這批標註的價值跟一份寫得好的 bug report 一樣:它不只告訴你哪裡錯,它告訴你錯在一個你的測試涵蓋不到的地方。
第二:
讓使用者有辦法反駁系統,是他們願意繼續看的前提。一個不能被反駁的系統,只能被整個關掉。
如果他手上唯一的工具是「照做」或「不理」,那當他覺得系統錯了就只剩一個選項。給他一個按鈕,他多了一個選項——而多出來的那個,剛好是你最需要的資料。
製造業早就把這件事做成了一條繩子。豐田產線上的安燈(Andon),任何一個作業員發現不對都可以拉,整條線停下來。它的設計哲學不是讓線常常停,是把喊停的權力放在最靠近問題的那個人手上。
而安燈真正的失效型態不是被拉太多次,是沒有人拉。繩子在那裡,大家都看得到,就是沒有人伸手——因為拉了要解釋、拉了會被記一筆、拉了之後沒有人跟進。這時候管理層看到的數字是「本月異常件數為零」,那個零是最危險的一種零。醫院的版本,是那張放在櫃子上沒有人填的異常通報單。
所以「這不是問題」這個按鈕不能只是存在。它要好按、按了要有人回、而且回的內容要讓他看得出來下個月真的改了。一個沒有人拉的安燈,跟沒有裝是一樣的;但它比沒裝更糟,因為它讓你以為你裝了。 就像一份從來沒有人真的寫過的 postmortem 範本——它證明不了流程健康,只證明沒有人願意付那個成本。
月報上除了「這個月標記了幾筆、成立了幾筆」,我們後來加了一欄:因為這套系統,現場這個月多花了幾小時。 估算很粗,作用不是精確,是讓噪音在報表上有一個位置——沒有它,優化壓力永遠只指向「多抓一點」。一個不出現在報表上的成本,不會被優化,只會被承受。
前面四條都在處理「太吵」。但還有一個死因跟吵完全無關,而且發生得更早。
這種東西要真的長進一間醫院,通常得過三道坎:進不了料、長不進流程、沒有人負責。第二道坎是死最多人的地方。 它的樣子很平凡:系統做好了,判得也還可以,輸出漂漂亮亮地呈現在一個新做的介面上。然後沒有人去開。
我們醫院的護理師,不會為了看 AI 去開第二個系統。
這不是抗拒新科技。她那個班別要看的東西已經排滿了:交班紀錄、醫囑、生命徵象、待辦事項、還有病人家屬在門口等著問話。你新增的是第 N+1 個要開的視窗,而她一天當中沒有任何一個時刻是「現在剛好有空來開第 N+1 個視窗」。
所以 AI 的產出要長成他原本就在用的那張表:原本看日報表的就進日報表,原本用通訊軟體交班的就發到那裡,原本每天早上開的是那個系統,就進那個系統的待辦。落點比介面重要——而落點是設計決策,不是上線後的推廣問題。
回頭看開場那一幕,這件事其實從第一秒就在畫面裡:護理長要先開清單、再切到另一個電子表格,而第三筆的紀錄還登在另一個系統模組。她做的每一次切換都是成本,那些成本不會出現在任何一張報表上,卻全部記在她對這套系統的印象裡。
你們的版本更直白:一個要另外登入才看得到的儀表板,等於不存在。 真正被用起來的東西都是長在既有路徑上的——是那個 PR 底下自動貼出來的那一則留言,不是一個要記網址的頁面。所以問題從來不只是「這條告警準不準」,還有一句:它出現在他今天本來就會經過的地方嗎?
那份電子清單裡的每一筆判定,單獨拿出來看都可以辯護。你把任何一行丟回去問模型「你為什麼這樣判」,它都給得出站得住腳的理由:引用了病歷的哪一段、對應到稽核條目的哪一條。放到委員會上一筆一筆念,每一筆都過得了關。
問題不在任何一筆上。問題出現在加總之後。
它每一筆都對得起自己,整份清單卻對不起讀它的人。
這種失效有個很麻煩的性質:它在單筆的尺度上測不出來。 評估集是一筆一筆的,準確率是一筆一筆算的,陷阱池(Day 22)也是一份一份跑的。這些工具全都運作在單筆層級,而噪音不住在那一層——它住在「一位護理長星期二早上打開信箱,一次要面對多少筆」那一層。而那一層沒有任何一份技術文件描述得到它,因為它不在系統裡,它在那個人的班表裡。
做監控的人對這件事應該很有感。每一條 alert rule 單獨 review 都合理,都有人講得出當初為什麼加,合起來就是一個沒人看的頻道。沒有任何一條該為此負責,但結果確實壞了。
Day 16 問過:你的系統看得見自己出錯嗎?噪音是最刁鑽的版本,因為系統輸出裡沒有任何一個欄位會隨噪音升高而變化。分數不會變、理由不會變、把握程度不會變。同一批判定切成十筆一份或五百筆一份,模型這端量到的完全一樣。
噪音是一個只有在系統外面才量得到的指標。
所以它必須從外面量,量的是人的行為:清單開啟率、複核完成率、平均回覆延遲、退回率,以及那個最誠實的訊號——這個月有沒有人主動問起這份清單。
這幾個數字沒有一個來自模型,它們全部是使用者行為的 log。判斷一個 feature 還活著不活著,你用的也是這一招:不是看它的 test 過不過,是看有沒有人在用。
這也讓我想通了 Day 9 的一個死路。我們當時要模型每筆多輸出一個「把握程度」想拿來排複核順序,結果分佈擠成一團排不了序。後來的理解是:那個欄位問錯了問題——它問「你對這個判定有多少把握」,但我需要知道的是「這一筆值不值得佔用一位資深同仁二十分鐘」。
把握程度是模型的內部狀態,值不值得看是接收端的成本問題。這兩件事本來就不該由同一個欄位回答。
排序後來改由外部資訊決定:這類問題的歷史成立率、病人的風險等級、這個單位本月已收到幾筆——全部是模型看不到、也不該由它決定的。
導入過程裡,使用者的抱怨走過三個階段:
後面兩種是同一個問題的後續階段,不是新問題,更不是態度問題。把它們歸類成「單位不配合」,是誤診。
第三種特別值得講。重複告警在技術上完全正確,那個狀況確實還在。但它傳達的訊息是:這個系統沒有記憶,也不承認你上次做過的事。 處理它不必動模型,需要的是狀態——已回覆的判定要記住,再次觸發時顯示上次回覆了什麼。這是流程層的事,對信任的影響卻比提高幾個百分點的準確率大得多。
還有一個不對稱。隨機的誤判使用者忍得住;穩定地在同一種情境誤判,使用者三次就學會了——他學到的不是「這一類要小心」,是「這個系統不懂我們單位」。這個印象一旦形成,你後面修得再漂亮都拿不回來,因為他已經不看了。Day 9 拆過偽陽性的三個來源我不重複,只補一句:同樣一個偽陽性率,隨機分布跟集中在某一種情境,對系統壽命的殺傷力差好幾倍,而我們平常算的那個率把兩者算成一樣。
一、靜默期。 新規則上線先只進統計、不進通知,跑一段時間,看它會產生多少筆、成立率落在哪。醫院對這件事有現成的說法叫試辦期:一條新的稽核條目在正式列入評分之前,先跑一輪不計分的,看它實際會打到哪些單位、打幾次。理由很簡單:
一個系統的信任額度是一次性發放的,用完不會補。
第一版寧可少報。你可以從安靜慢慢變吵,很難從吵變回被信任。這就是 shadow mode。
二、逐規則追蹤,不看總體。 總體的成立率會被幾條表現好的規則稀釋,把那條害死你的規則藏起來。每一條判準要有自己的成立率、退回率、觸發量。這跟看稽核表是一樣的:那一條年年都有人不合格的條目,跟那一條從來沒有人不合格的條目,問題完全不同,但總分會把兩者蓋成同一個顏色。
三、規則有生命週期,會過期。 上線 → 觀察期 → 正式 → 降級 → 下架。成立率連續幾個月跌破線的規則,自動降到「僅供參考」通道,不必開會決定。規則會過期不是因為它寫壞了,是因為現場變了——兩個病房合併了、表單改版了、那件事從護理紀錄搬到另一張單子上了、主責的同仁換人了。昨天正確的規則今天就是噪音來源,而且沒有人會通知你。這是 Day 26 漂移的另一面:漂的不只是模型,還有模型腳下那塊地。
最後補一句:這些都不能靠「把模型調準一點」解決。降噪需要的是 domain 邊界——哪份紀錄實際登在哪裡、哪個單位的流程跟別人不一樣。這些只在現場的人腦子裡,所以降噪註定是要跟單位一起做的事,不是品管室關起門調參數。護理長指著第三行說「這個我們登在另一張表上」的時候,她給我的不是一筆錯誤,是一條我在辦公室裡永遠查不到的規則。
開頭我說 Day 9 留了三樣東西沒處理完。指標怎麼用、閾值後來調了沒有,前面都回答了。剩下第三樣,那句話。
Day 1 說,這 30 天談的是規則寫不下來的那一半。今天這篇是那一半裡最不像技術問題、卻最會決定成敗的一段:判準寫得再好,如果沒有人願意讀它產生的結果,那條判準等於沒有寫。
而小葉那句話裡真正的資訊,不在「沒有人會想看」,在「第二次」。那講的是這套東西的壽命——而壽命這件事,在我們當時盯著的任何一個指標裡都沒有位置。我當時聽成抱怨。
它其實是一份規格。


 iThome鐵人賽
 看影片追技術